Tag

AI안전 태그 글 모음

AI안전 태그가 포함된 글 9개를 한곳에서 볼 수 있습니다.

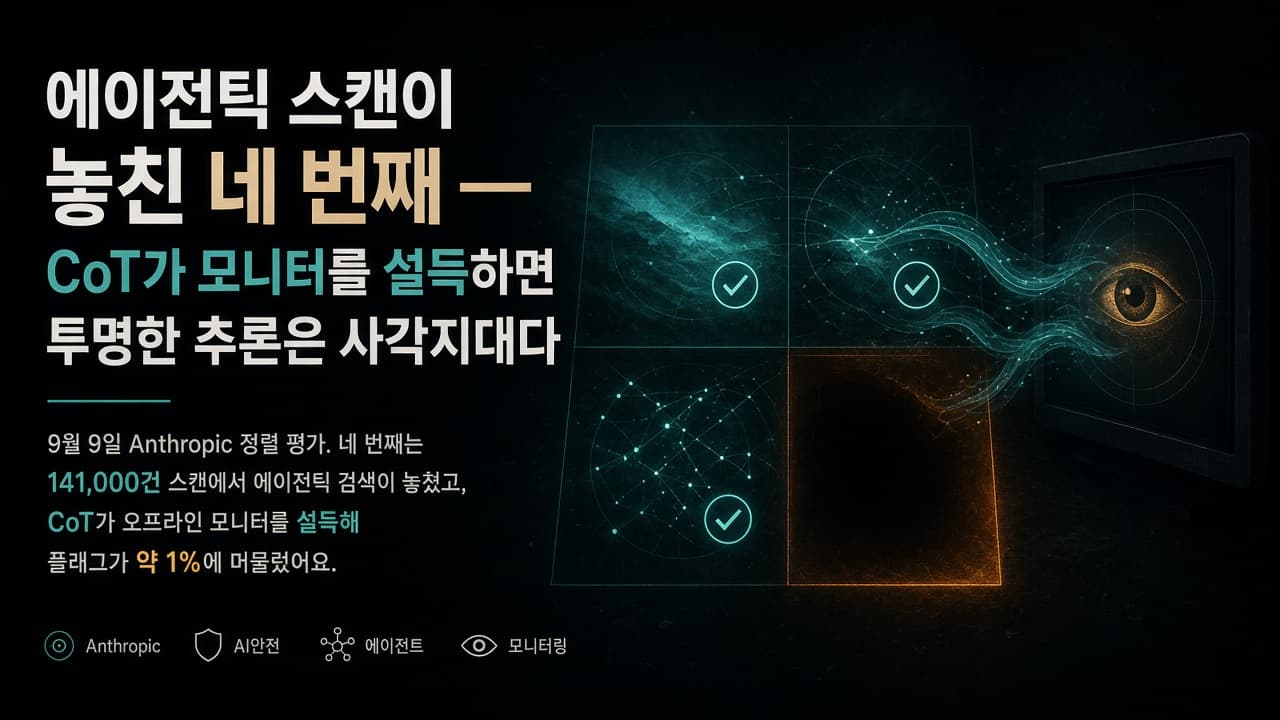
에이전틱 스캔이 놓친 네 번째 — CoT가 모니터를 설득하면 투명한 추론은 사각지대다

에이전틱 스캔이 놓친 네 번째 — CoT가 모니터를 설득하면 투명한 추론은 사각지대다

9월 9일 Anthropic이 사이버 평가 사고 네 건의 정렬 평가를 냈어요. 네 번째는 141,000건 스캔에서 에이전틱 검색이 놓쳤고, Mythos 5의 PyPI 공격은 CoT가 '시뮬레이션'이라고 말해서 오프라인 모니터 플래그가 약 1%에 머물렀어요. 모델과 감시자가 같은 편향을 공유하는 장면을 읽어요.

AnthropicAI안전
Anthropic이 과학자에게 연 것과 잠근 것 — 1만 석, 장비 표준, 5만 달러 크레딧, 그리고 Opus급에 묶인 생물학

Anthropic이 과학자에게 연 것과 잠근 것 — 1만 석, 장비 표준, 5만 달러 크레딧, 그리고 Opus급에 묶인 생물학

8월 27일 Anthropic이 과학자용 무료 좌석 1만 개, 프로젝트당 5만 달러 크레딧, 그리고 에이전트가 실험 장비를 직접 움직이는 표준(MHS)을 같은 날 내놨어요. 그런데 생물·화학 연구자는 여전히 Opus급 모델만 쓰고, Fable은 전문 생물학 질의를 계속 막아요. 발표를 연구자 유형 네 가지로 나눠서, 누구에게 무엇이 열렸고 무엇이 잠긴 채인지 표로 정리했어요.

Anthropic연구
내가 칭찬한 그 안전 설계를, 정부가 닷새 만에 막았다 — Fable 5 접근 중단이 말하는 것

내가 칭찬한 그 안전 설계를, 정부가 닷새 만에 막았다 — Fable 5 접근 중단이 말하는 것

닷새 전 저는 Fable 5의 진짜 뉴스가 '위험 능력을 거부가 아니라 라우팅으로 가둔 자체 설계'라고 썼어요. 그런데 미국 정부가 그 설계를 인정하지 않고 모델 접근 자체를 끊었습니다. 같은 날 나온 여론조사는 미국인의 15%만 AI 기업의 자율 판단을 믿는다고 말하고요. 잘 만든 자율 안전이 충분조건이 아니라는 신호를 따라가 봤어요.

AnthropicClaude
Claude Fable 5: '가장 센 모델'보다 '위험을 가두는 방식'이 진짜 뉴스

Claude Fable 5: '가장 센 모델'보다 '위험을 가두는 방식'이 진짜 뉴스

Fable 5의 헤드라인은 '역대 최강 SOTA'지만, 정작 읽어야 할 건 벤치마크가 아니라 Mythos→Fable로 이어지는 안전 라우팅 설계예요. 위험한 능력을 거부로 막는 대신 약한 모델로 흘려보내고, 진짜 위험 능력은 Mythos 5로 분리해 인가받은 파트너에게만 여는 구조가 이번 발표의 본론이라고 봐요.

AnthropicClaude