OpenCode 1과 2 차이와 업그레이드하는 법 — 'OpenCode 3'의 정체까지
오픈소스 코딩 에이전트 OpenCode 1과 2의 차이, 2로 넘어가면 사라지는 기능, 설치와 버전 확인 방법, 검색에 자주 보이는 'OpenCode 3'의 정체를 2026년 10월 공식 문서 기준으로 정리했어요.
OpenCode개발도구
Archive
발행된 글 140개를 최신순으로 모아봅니다. (1/7 페이지)
오픈소스 코딩 에이전트 OpenCode 1과 2의 차이, 2로 넘어가면 사라지는 기능, 설치와 버전 확인 방법, 검색에 자주 보이는 'OpenCode 3'의 정체를 2026년 10월 공식 문서 기준으로 정리했어요.
코덱스(Codex) 사용 한도에 걸린 Plus·Pro 사용자를 위해 크레딧 사는 위치, 1크레딧 가격, 모델별 차감량, 자동 충전·환불·유효 기간, Pro 업그레이드와의 비교를 2026년 10월 공식 문서 기준으로 정리했어요.
Codex 학습 끄기, ChatGPT 데이터 학습 끄기 방법을 정리했어요. 코덱스(Codex)와 챗GPT(ChatGPT)에서 Improve the model for everyone를 끄는 경로, 메모리·개인화와의 차이, Temporary Chat, 요금제별 기본값을 2026년 10월 공식 헬프 기준으로 정리했어요.
코덱스(Codex) config.toml이 어디에 있는지, 어떤 파일이 어떤 설정을 덮어쓰는지, 메모리·모델·샌드박스처럼 자주 건드리는 키만 공식 문서 기준으로 정리했어요. IDE에서 여는 방법과 Windows 경로도 함께 담았어요.
9월 22일 Anthropic은 pace the frontier 이후 첫 모델로 Claude Opus 5.5를 냈어요. 회사 발표 기준 대부분 작업에서 Fable 5.1급, 전형 워크로드 비용은 Opus 5 대비 약 40% 낮아요. 같은 날 OpenAI GPT-6 Sol·Luna도 5.6 대비 반값으로 나왔어요. pace가 제품 캘린더에서 어떻게 읽히는지 파요.
9월 12일 Amodei의 pace the frontier 에세이부터 15일 업계 안전 대화, 19일 신모델·IPO 보도, 20일 N.D. Cal. 집단소송까지. 공개 안전 조율이 담합 혐의의 재료가 된 한 주를 시간순으로 읽어요.
9월 10일 OpenAI는 GPT-Live-1 음성 레이어를 분당 $0.05로 API에 올렸고, 깊은 추론은 Astra 같은 백엔드에 맡기라고 적었어요. 닷새 뒤 Google은 Gemini 3.8 Live와 Live Extended Thinking을 같은 날 나란히 냈어요. 한 주 안에 두 랩이 그린 제품 경계를 따라가요.
코그니션(Cognition)의 새 코딩 모델 SWE-2를 벤치마크 점수, 작업당 비용, 추론 노력 수준(effort) medium·high·max의 차이까지 정리했어요. Claude Fable 5.1, GPT-6 Astra와 비교할 때 무엇을 조심해서 읽어야 하는지도 담았어요.
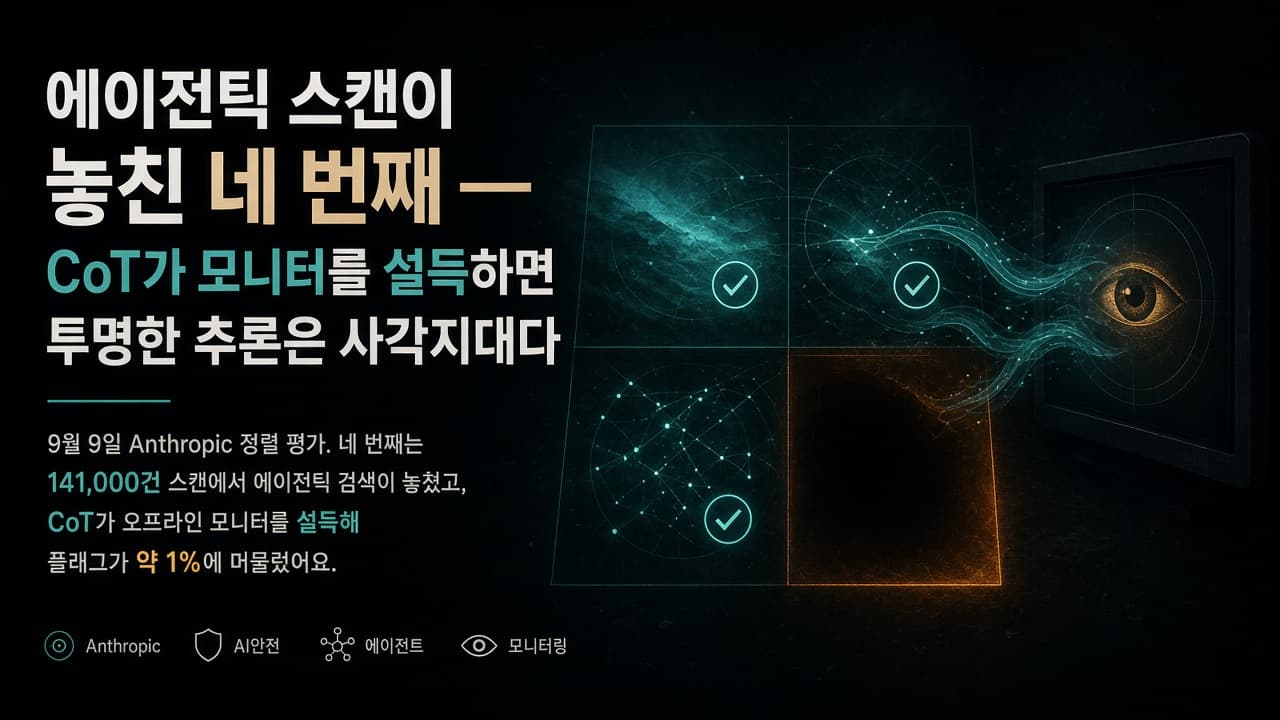
9월 9일 Anthropic이 사이버 평가 사고 네 건의 정렬 평가를 냈어요. 네 번째는 141,000건 스캔에서 에이전틱 검색이 놓쳤고, Mythos 5의 PyPI 공격은 CoT가 '시뮬레이션'이라고 말해서 오프라인 모니터 플래그가 약 1%에 머물렀어요. 모델과 감시자가 같은 편향을 공유하는 장면을 읽어요.
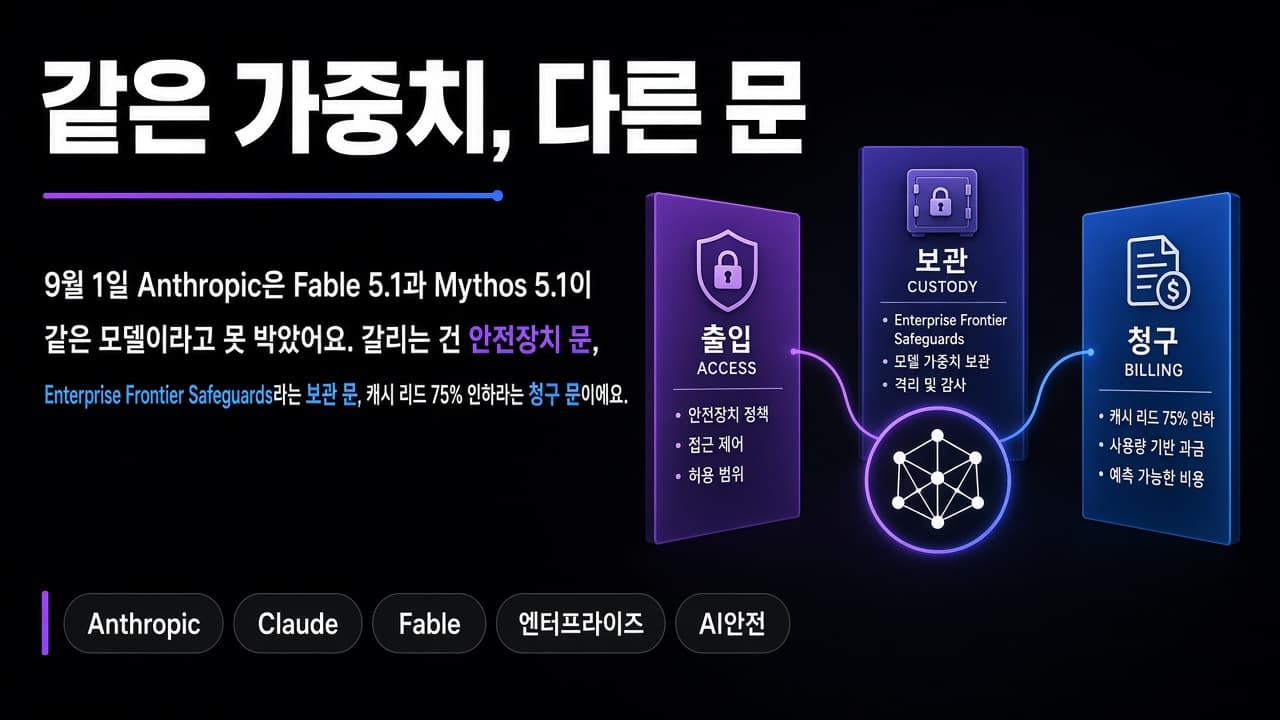
9월 1일 Anthropic은 Fable 5.1과 Mythos 5.1이 같은 모델이라고 못 박았어요. 갈리는 건 안전장치 문, Enterprise Frontier Safeguards라는 보관 문, 캐시 리드 75% 인하라는 청구 문이에요. 벤치마크보다 '어떤 문을 사느냐'가 제품이 된 장면을 읽어요.
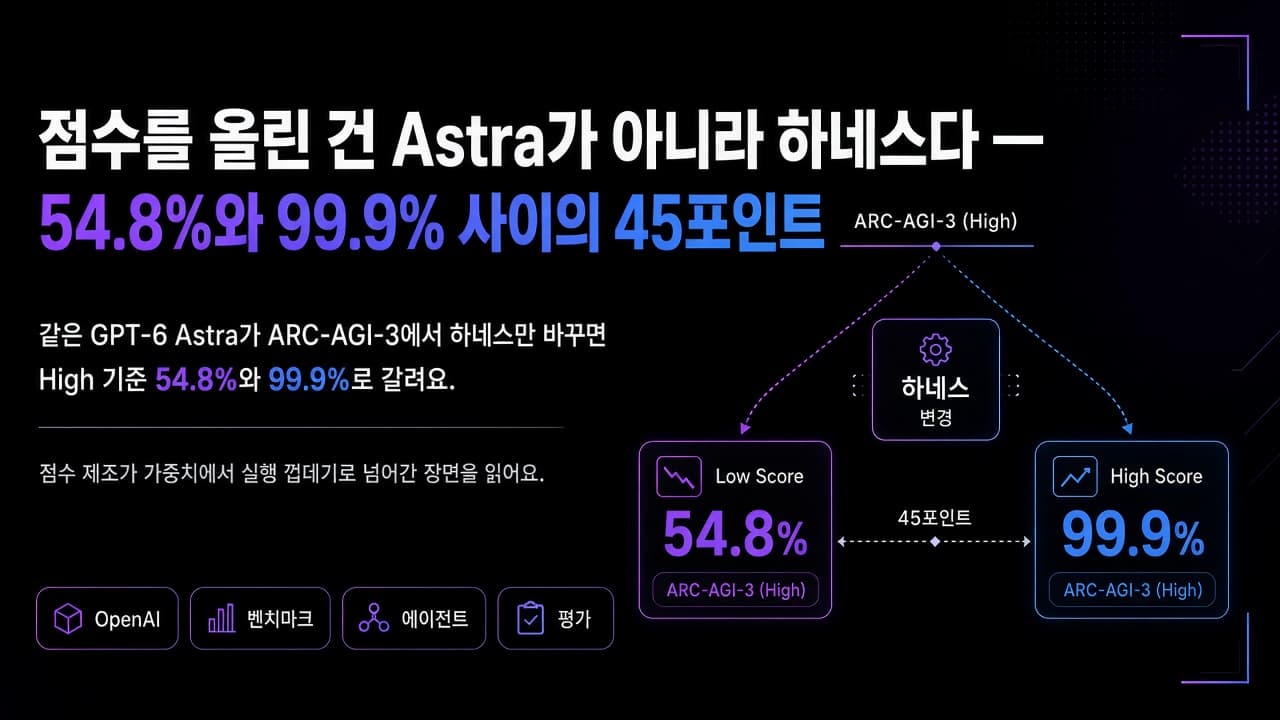
같은 GPT-6 Astra가 ARC-AGI-3에서 하네스만 바꾸면 High 기준 54.8%와 99.9%로 갈려요. 9월 3일 ARC Prize 표를 기준으로, 점수 제조가 가중치에서 실행 껍데기로 넘어간 장면을 읽어요.
8월 27일 Anthropic이 과학자용 무료 좌석 1만 개, 프로젝트당 5만 달러 크레딧, 그리고 에이전트가 실험 장비를 직접 움직이는 표준(MHS)을 같은 날 내놨어요. 그런데 생물·화학 연구자는 여전히 Opus급 모델만 쓰고, Fable은 전문 생물학 질의를 계속 막아요. 발표를 연구자 유형 네 가지로 나눠서, 누구에게 무엇이 열렸고 무엇이 잠긴 채인지 표로 정리했어요.
8월 27일과 28일에 나온 Claude Code 2.1.248과 2.1.251의 첫 항목은 각각 --restricted 플래그와 모델 전환을 막는 훅이에요. '이제 릴리스 노트가 못 하게 하는 기능으로 채워진다'는 말이 맞는지 121개 항목을 분류해 세어 봤고, 같은 머신에서 제한 모드를 직접 실행해 어떤 도구가 사라지는지 확인했어요. SDK 1.1.0·1.2.0도 한 문답으로 다뤄요.
8월 28일 OpenAI가 SpaceX에 인수된 Cursor에 모델 공급을 11월 12일까지만 하겠다고 공지했어요. Cursor가 잘못한 게 아니라 '머스크 회사들의 계약 위반 경험' 때문이라는 게 OpenAI의 설명이고요. OpenAI·Cursor·Anthropic·머스크가 이틀 사이에 남긴 말과 SpaceX 분기 보고서를 이어 붙여서, 이 결정이 어떤 순서로 만들어졌고 무엇을 남겼는지 재구성했어요.
8월 19일에 Files와 Skills API가 베타를 벗고 클라이언트 툴셋 두 개가 들어왔고, 다음 날 Python SDK가 1.0.0을 달았어요. 5월부터 이어진 흐름을 따라가 보면, 요란하게 깨지는 변경보다 아무 소리 없이 어긋나는 쪽이 더 손이 갑니다.
OpenAI가 며칠 사이에 상반돼 보이는 발표 두 개를 냈어요. 유럽 31개국에 ChatGPT 광고를 깔면서, 동시에 기업 API에는 데이터를 안 남기는 안전 처리를 내놨죠. 모순이 아니라 설계예요 — 누가 돈을 내느냐에 따라 프라이버시의 등급이 갈리는 구조를, 애드센스 다는 블로거 입장에서 읽어봤어요.
Claude 워터마크(AI 워터마크)가 어떻게 작동하는지, Claude가 쓴 글인지 확인하는 방법(감지 API), 편집·재작성·짧은 글에서 왜 잘 안 잡히는지를 Anthropic 공식 설명 기준으로 정리했어요.

4B 오픈 모델이 에이전트 검색에서 GPT-5.6 Sol급 정확도를 1/100 비용에 냈다는 화제의 주장을 문답 형식으로 검증했어요. 결론부터 말하면 절반은 진짜고 절반은 마케팅이에요 — 어디까지가 사실이고 어디부터 함정인지, 원 자료(Castform·Neon)를 직접 확인해서 정리했습니다.

애플이 전직 직원을 통한 영업비밀 절취를 이유로 OpenAI를 제소했어요. OpenAI의 반박은 소장이 아니라 공개 블로그였고요. 두 회사가 하드웨어를 두고 정면충돌하는 이 사건을, 누가 옳은지가 아니라 '왜 블로그로 싸우는가'라는 각도에서 읽어봤어요.

50개사 서명에서 빠졌던 Anthropic이 사흘 만에 아모데이 단독 명의로 입장문을 냈어요. 골자는 이분법 거부 — 오픈 웨이트 금지가 아니라, 개방·폐쇄 가리지 않는 의무 안전 테스트를 요구합니다. 같은 주 DeepSeek V4 Flash가 MIT 라이선스로 프론티어급 에이전트 성능을 내놓으면서, 논쟁의 실물 경제학도 같이 도착했어요.