Cognition SWE-2 정리 — 벤치마크·비용을 Fable 5.1·GPT-6 Astra와 비교
코그니션(Cognition)의 새 코딩 모델 SWE-2를 벤치마크 점수, 작업당 비용, 추론 노력 수준(effort) medium·high·max의 차이까지 정리했어요. Claude Fable 5.1, GPT-6 Astra와 비교할 때 무엇을 조심해서 읽어야 하는지도 담았어요.
Cognition코딩에이전트
Tag
벤치마크 태그가 포함된 글 3개를 한곳에서 볼 수 있습니다.
코그니션(Cognition)의 새 코딩 모델 SWE-2를 벤치마크 점수, 작업당 비용, 추론 노력 수준(effort) medium·high·max의 차이까지 정리했어요. Claude Fable 5.1, GPT-6 Astra와 비교할 때 무엇을 조심해서 읽어야 하는지도 담았어요.
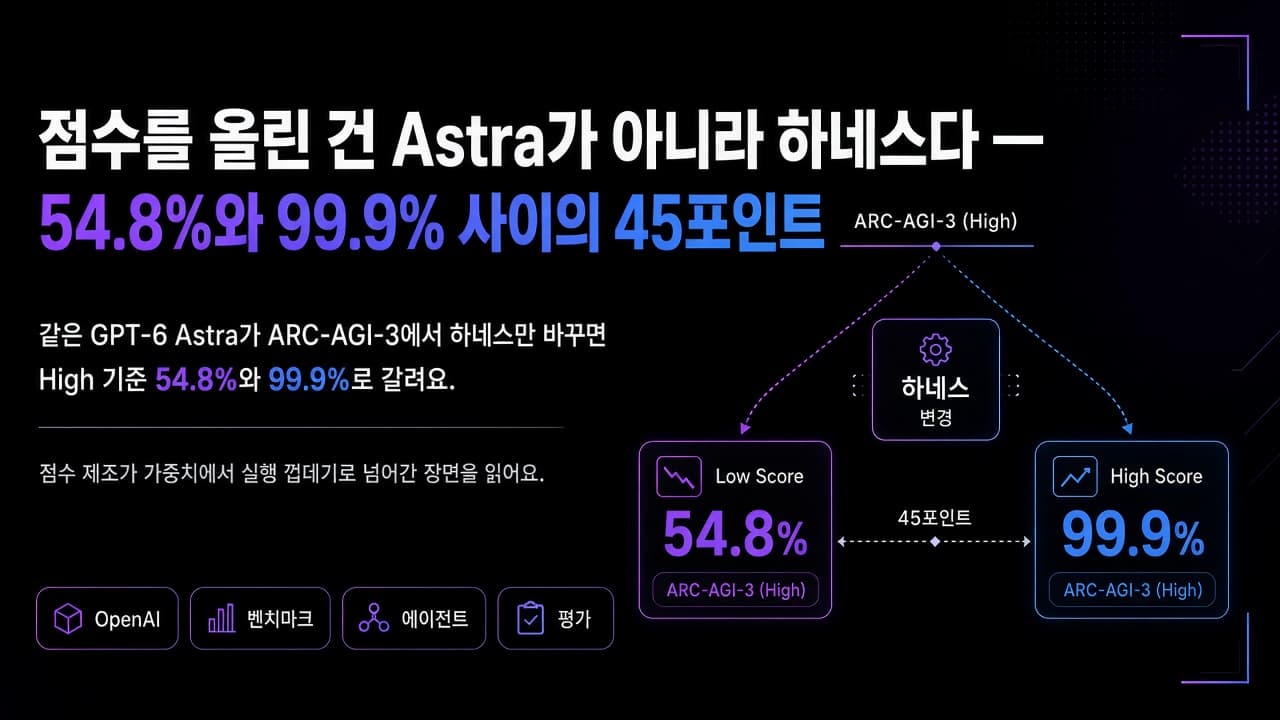
같은 GPT-6 Astra가 ARC-AGI-3에서 하네스만 바꾸면 High 기준 54.8%와 99.9%로 갈려요. 9월 3일 ARC Prize 표를 기준으로, 점수 제조가 가중치에서 실행 껍데기로 넘어간 장면을 읽어요.

OpenAI도 SWE-bench Verified 점수 보고를 중단했습니다. 138개 문제 중 59.4%에 결함이 있고, 데이터 오염까지. AI 코딩 평가의 다음 단계를 살펴봤어요.