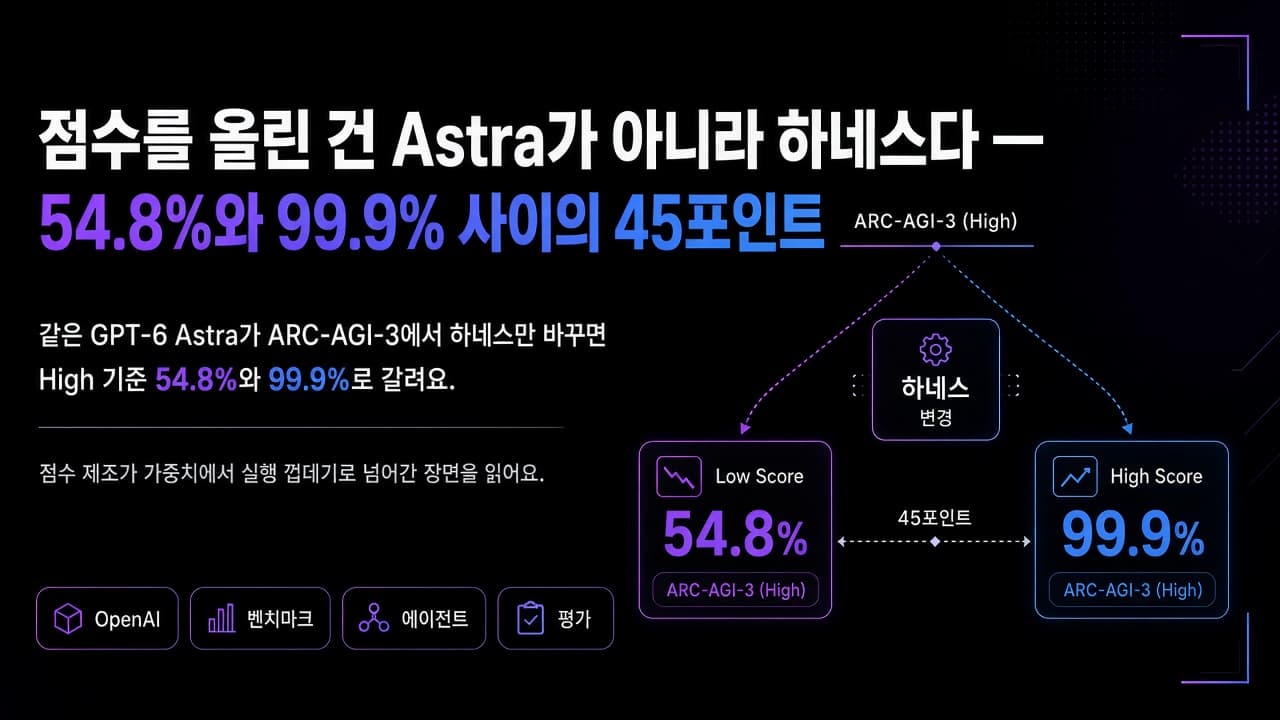
점수를 올린 건 Astra가 아니라 하네스다 — 54.8%와 99.9% 사이의 45포인트
한줄평
ARC Prize가 9월 3일에 공개한 표에서, 같은 GPT-6 Astra High는 Standard 하네스 54.8%와 Provider Adapter 99.9%로 갈려요. 약 45포인트 차이는 모델 교체가 아니라 실행 껍데기 교체예요. Standard(max) 최고 62.7%도 Adapter의 어느 추론 수준보다 낮아요. 헤드라인 99.9%만 보면 Astra를 산 것처럼 보이지만, 실제로 제품화된 건 불투명 추론 상태 보존과 compaction을 묶은 어댑터예요. 국내 팀이 먼저 고정해야 할 건 모델 이름보다 평가 프로토콜이에요.
9월 3일 ARC Prize가 GPT-6 Astra의 ARC-AGI-3 결과를 올렸어요. 표의 High 행만 먼저 보면 이래요. Standard 하네스 54.8%, Provider Adapter 하네스 99.9%. 같은 모델, 같은 Semi-Private 세트, 같은 추론 수준인데 점수가 약 45포인트 갈려요. 헤드라인은 종종 Adapter 쪽 최고치와 Standard 쪽 max 최고치(62.7%)를 나란히 놓지만, 저는 High를 같은 줄에 고정해서 읽는 쪽이 더 정직하다고 봐요. 모델이 바뀐 게 아니라 실행 껍데기가 바뀐 장면이니까요.
2026년 10월 업데이트: 하네스(harness)가 처음이라면 하네스 엔지니어링 뜻과 예시부터 읽어 보세요.
"Astra가 99.9%를 찍었다"는 문장은 불완전해요. 정확히 쓰면 "Astra + Provider Adapter가 99.9%를 찍었다"예요. Astra가 약하다는 말이 아니에요. Standard에서도 이전 세대보다 크게 올랐고, Adapter에서는 행동 효율이 인간 중앙값을 넘는 구간이 나왔어요. 다만 측정 주체는 이미 가중치에서 실행 껍데기로 옮겨 갔어요.
광고
같은 High, 다른 껍데기
ARC Prize가 표에 붙인 정의를 그대로 옮기면 이래요. Standard 하네스는 "모델이 환경 전반에 걸쳐 유지할 메모를 스스로 선택하게" 하고, Provider Adapter 하네스는 "요청 사이에 불투명한 추론 상태를 보존하고, 긴 대화에는 compaction을 써서 이전 작업을 재사용하게" 해요. 전자는 공급자 중립의 최소 인터페이스고, 후자는 OpenAI가 Responses API에 심어 둔 문맥 관리 기능을 평가 루프에 연결한 쪽이에요. OpenAI 문서도 compaction 항목을 "사람이 해석하라고 만든 게 아니라 opaque"라고 못 박아요. 우리가 점수표에서 보는 건 가중치만이 아니라, 그 opaque 상태를 턴 사이로 넘기는 제품 기능이에요.
같은 High만 놓고 보면 54.8 → 99.9예요. Standard의 최고치인 max 62.7%조차 Adapter의 어느 추론 수준보다 낮아요. ARC Prize는 Adapter 쪽이 양쪽 하네스가 모두 푼 167개 게임-추론 쌍 기준으로 경과 시간 약 3.66배 빠르고 토큰 49% 적었다고도 적었어요. 점수가 오른 동시에 실행 비용 구조까지 바뀐 거예요. 가중치를 더 키운 결과가 아니라, 이전 턴의 작업을 버리는지 이어 받는지가 점수와 영수증을 같이 움직인 결과로 읽혀요.
ARC Prize 스스로도 질문을 둘로 갈랐어요. Standard는 "같은 최소 인터페이스에서 모델끼리 어떻게 비교되나", Adapter는 "공급자가 설계한 문맥 관리까지 쓸 때 얼마나 되나". 둘 다 리더보드에 올리겠다고 했고, 조건 라벨을 붙이겠다고 했어요. 앞으로는 모델 이름만 보고 점수를 인용하면 틀린 인용이 되기 쉽다는 선언에 가깝습니다.
점수를 못 내게 만드는 것도 하네스다
같은 주간에 반대 방향 증거도 있어요. Anthropic Fable 5 / Mythos 5 계열의 후속인 Fable 5.1은 ARC-AGI-1·2 점수는 공개됐지만 ARC-AGI-3는 비어 있어요. 시스템 카드는 출시 시점에 결과가 없었다고만 적었고, 공개 리뷰들은 API가 요청을 잘못 분류하는 문제 때문에 점수를 내지 못했다고 전해요. 모델 카드의 능력이 있어도 평가 경로의 껍데기가 어긋나면 숫자 자체가 안 생기는 거예요. 점수를 "올리는" 장치가 하네스라면, 점수를 "못 내게 만드는" 장치도 하네스예요.
Google 쪽 Antigravity도 같은 축이에요. 문서는 에이전트 호출마다 샌드박스를 띄우고 계획·행동·관찰 루프를 돌린다고 쓰고, SDK 안내문은 Gemini API가 상태 없는 호출이라면 Antigravity는 "에이전틱 루프를 직접 만들지 않고 주어지는" 런타임이라고 정리해요. 가중치 경쟁이 끝난 자리에서, 회사들은 실행 껍데기를 제품처럼 팔기 시작했어요. OpenAI Harness팀이 Codex만으로 제품을 만든 실험을 다룰 때 나왔던 교훈 — "모델을 더 세게"가 아니라 "환경·피드백·제약을 설계하라" — 이 표가 그 문장을 숫자로 다시 던진 셈이에요.
광고
그래서 무엇을 사는지
Astra를 살지 Claude를 살지보다 먼저, 팀 내부 평가에 네 칸만 고정해도 싸게 먹혀요. 모델 ID와 추론 수준(High인지 max인지), 하네스/어댑터 이름(최소 루프인지 compaction·메모리 루프인지), 상태 보존 규칙(턴 사이 reasoning을 이어 받는지 매 호출마다 버리는지), 비용 단위(점수만이 아니라 통과당 달러·토큰·벽시계). ARC 표가 High에서 Adapter가 더 싸게 나온 이유가 여기 있어요.
영업 슬라이드에 99.9%만 있으면 하네스 이름과 상태 보존 규칙을 물어보면 돼요. 답이 없으면 그 숫자는 모델 점수가 아니라 특정 실행 제품의 점수예요. Cursor 기본 루프에서 잘 나온 결과를 우리 API 래퍼로 옮길 때 상태가 끊기면, Astra가 나빠진 게 아니라 껍데기가 바뀐 거예요. "Astra 99.9%"는 클릭을 잘 받지만, 랜딩 뒤에 프로토콜이 없으면 신뢰가 바로 깨져요. 짧게라도 "같은 모델, High 기준 54.8 vs 99.9, 차이는 Provider Adapter"처럼 조건을 박아 두는 쪽이 오래 가요.
Astra의 기호적 속기나 인간 대비 행동 효율은 축하할 만한 장면이 맞아요. ARC Prize도 AGI 선언은 분명히 거절했어요. 제가 가져가는 건 그 다음 문장이에요. 2026년 가을의 벤치마크 헤드라인에서 실제로 제품화된 건 모델 이름보다 점수를 만드는 실행 껍데기예요. 가중치를 고르는 일과 하네스를 고르는 일을 같은 구매 결정으로 다루기 시작한 팀이, 숫자 싸움에서 덜 속을 거예요.
근거가 된 소식: OpenAI's GPT-6 Astra on ARC-AGI-3 (ARC Prize, 9/3), Compaction (OpenAI API), Claude Fable 5.1 & Mythos 5.1 System Card — §8.16 ARC-AGI, Antigravity agent (Google AI for Developers). 한국어 요약 참고: GeekNews #33202 — 본문 권위는 ARC·OpenAI·Anthropic·Google 원문을 기준으로 했어요.
광고
Claude Code, OpenCode 같은 AI 코딩 도구를 직접 쓰면서 AI 업계의 변화를 개발자 관점에서 기록합니다. 단순 번역이 아니라 써본 경험과 해석을 함께 남기려고 해요.
관련 글
분당 $0.05가 산 자리 — 음성 프론트와 추론 백엔드가 갈라진 주
9월 10일 OpenAI는 GPT-Live-1 음성 레이어를 분당 $0.05로 API에 올렸고, 깊은 추론은 Astra 같은 백엔드에 맡기라고 적었어요. 닷새 뒤 Google은 Gemini 3.8 Live와 Live Extended Thinking을 같은 날 나란히 냈어요. 한 주 안에 두 랩이 그린 제품 경계를 따라가요.
OpenAI Codex 보안 운영 전략: 샌드박싱부터 텔레메트리까지
OpenAI가 Codex를 어떻게 안전하게 운영하는지 정리했어요. 샌드박싱, 승인 메커니즘, 네트워크 정책, 에이전트 텔레메트리까지 — 코딩 에이전트를 도입하려는 팀이라면 참고할 만한 내용이에요.
Codex 대규모 업데이트: 컴퓨터 사용, 이미지 생성, 메모리까지 한번에
OpenAI Codex가 컴퓨터 직접 조작, 이미지 생성, 메모리, 자동 스케줄링까지 추가했습니다. 코딩 도구를 넘어서 범용 에이전트로 진화 중이에요.